اگر میخواهید وارد هوش مصنوعی شوید، تقریباً همه یک توصیه به شما میکنند: «پایتون یاد بگیر». ولی پایتون زبان بزرگی است و کسی نمیگوید کدام بخشش را و تا چه عمقی. نتیجه این است که خیلیها ماهها روی مباحثی وقت میگذارند که در هوش مصنوعی کمتر به کارشان میآید، یا برعکس، بدون پایهی کافی سراغ مدلسازی میروند و گیر میکنند.
این مقاله دقیق میگوید برای هوش مصنوعی چه چیزهایی از پایتون لازم است، کدام کتابخانهها را به چه ترتیبی یاد بگیرید، و اولین مدل یادگیری ماشین با پایتون چه شکلی است.
چرا پایتون زبان اصلی هوش مصنوعی است؟
- کتابخانهها: تقریباً همهی ابزارهای مهم هوش مصنوعی، از NumPy تا PyTorch، اول برای پایتون ساخته میشوند.
- سادگی: کد پایتون به زبان انسان نزدیک است، پس تمرکز روی ایدهی هوش مصنوعی میماند، نه روی پیچیدگی زبان.
- جامعه: بیشتر آموزشها، مقالهها و جواب سوالها در این حوزه با پایتون است.
پشت صحنه، محاسبات سنگین این کتابخانهها با زبانهای سریعتری مثل C نوشته شده؛ پایتون زبانی است که شما با آن این قدرت را کنترل میکنید.
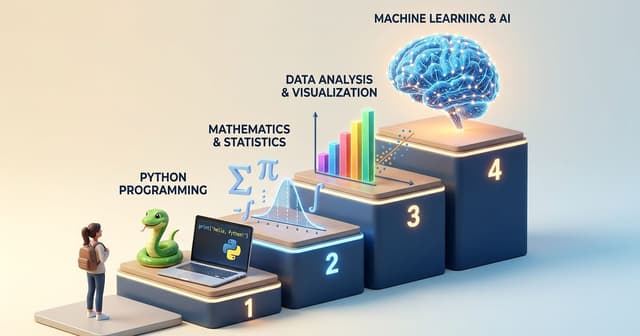
مرحله ۱: کدام بخشهای پایتون لازم است؟
برای شروع هوش مصنوعی لازم نیست متخصص پایتون باشید. اینها کافی است:
- ضروری: متغیر و انواع داده، شرط و حلقه، تابع، لیست و دیکشنری، کار با فایل.
- مهم: list comprehension، نصب کتابخانه با pip، خواندن پیغام خطا.
- کافی است آشنا باشید: کلاس و شی. کتابخانههای هوش مصنوعی کلاسمحورند و باید بتوانید کد آنها را بخوانید، حتی اگر خودتان کلاس پیچیده ننویسید.
اگر از صفر شروع میکنید، نقشهی راه پایتون از صفر همین مباحث را در حدود دو ماه پوشش میدهد.
مرحله ۲: کتابخانههای داده
هوش مصنوعی یعنی کار با داده، و قبل از هر مدلی باید بتوانید داده را بخوانید، تمیز کنید و ببینید. سه کتابخانه، به همین ترتیب:
| کتابخانه | کاربرد | چرا مهم است |
|---|---|---|
| NumPy | کار با آرایه و محاسبات عددی | پایهی تقریباً همهی کتابخانههای دیگر است |
| Pandas | خواندن و تمیز کردن دادههای جدولی | بیشتر وقت یک پروژهی واقعی صرف همین مرحله میشود |
| Matplotlib | رسم نمودار | قبل از مدلسازی باید داده را ببینید |
یک نمونه از کار با Pandas:
import pandas as pd

data = pd.DataFrame({
    "city": ["Tehran", "Shiraz", "Tehran", "Tabriz"],
    "price": [120, 80, 150, 90],
})

print(data["price"].mean())
print(data.groupby("city")["price"].mean())
در پروژههای واقعی، داده معمولاً از یک فایل CSV یا اکسل با pd.read_csv خوانده میشود.
مرحله ۳: یادگیری ماشین با scikit-learn
scikit-learn بهترین کتابخانه برای شروع یادگیری ماشین است: الگوریتمهای اصلی را با یک رابط ساده و یکسان در اختیارتان میگذارد. اولین مدل شما میتواند این باشد؛ مدلی که از روی اندازهی گلبرگها، نوع گل را تشخیص میدهد:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = load_iris(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

model = DecisionTreeClassifier(random_state=42)
model.fit(X_train, y_train)
print("Accuracy:", model.score(X_test, y_test))
این چند خط همهی مراحل اصلی یادگیری ماشین را دارد: داده را به دو بخش آموزش و آزمون تقسیم میکند، مدل را روی بخش آموزش آموزش میدهد و دقتش را روی دادهای میسنجد که قبلاً ندیده. این جداسازی مهمترین قاعدهی کل حوزه است: مدل را هرگز با همان دادهای که از آن یاد گرفته نسنجید.
مرحله ۴: یادگیری عمیق با PyTorch یا TensorFlow
برای کار با تصویر، صدا و متن و ساختن شبکههای عصبی، سراغ یکی از این دو بروید. هر دو قدرتمندند؛ PyTorch در پژوهش و آموزشهای جدید رایجتر شده و TensorFlow در بسیاری از محیطهای صنعتی استفاده میشود. فقط یکی را انتخاب کنید؛ مفاهیم بین این دو قابل انتقال است.
تفاوت یادگیری ماشین و یادگیری عمیق را در این مقاله توضیح دادهایم.
مسیر دیگر: ساختن برنامه با مدلهای آماده
لازم نیست حتماً مدل را از صفر بسازید. امروز بخش بزرگی از کارهای هوش مصنوعی، ساختن برنامه روی مدلهای زبانی آماده است: پایتون به API یک مدل وصل میشود و مثلاً چتبات پشتیبانی، خلاصهساز اسناد یا دستیار جستجو در اطلاعات یک شرکت میسازید. این مسیر ریاضی کمتری میخواهد و به پایتون خوب، کار با API و آشنایی با مفاهیمی مثل پرامپت و RAG نیاز دارد. برای این اصطلاحها مقالهی هوش مصنوعی چیست را ببینید.
ابزار کار: Jupyter Notebook
بیشتر کارهای داده و هوش مصنوعی در Jupyter Notebook انجام میشود: کد را تکهتکه اجرا میکنید و نتیجهی هر مرحله، از جدول تا نمودار، همانجا نمایش داده میشود. برای یادگیری، این بهترین محیط است.
چقدر ریاضی لازم است؟
برای استفاده از کتابخانهها و ساختن اولین مدلها، ریاضی دبیرستان کافی است. برای فهمیدن عمیق الگوریتمها و کار حرفهای، آمار و احتمال، جبر خطی و کمی حسابان لازم میشود. خبر خوب اینکه اینها را میشود همزمان با کار عملی یاد گرفت. جزئیاتش در مقالهی ماشین لرنینگ از کجا شروع کنم آمده.
نقشهی زمانی پیشنهادی
| مرحله | زمان تقریبی | خروجی |
|---|---|---|
| پایهی پایتون | ۲ ماه | چند پروژهی کوچک |
| NumPy، Pandas، Matplotlib | ۱ ماه | تحلیل یک دادهی واقعی با نمودار |
| یادگیری ماشین با scikit-learn | ۲ تا ۳ ماه | دو سه پروژه مثل پیشبینی قیمت یا تشخیص اسپم |
| یادگیری عمیق | از اینجا به بعد | پروژهی تصویر یا متن |
این زمانها برای کسی است که روزی یکی دو ساعت وقت میگذارد و مهمتر از سرعت، این است که هیچ مرحلهای را بدون پروژه رد نکنید.
سوالات رایج
«میشود مستقیم از یادگیری ماشین شروع کنم و پایتون را در مسیر یاد بگیرم؟»
ممکن است، ولی معمولاً کندتر میشود. کسی که پایتون را بلد نیست، نمیداند خطا از کد اوست یا از مدل، و وقت زیادی سر مشکلات سادهی زبان هدر میدهد.
«کامپیوتر قوی لازم دارم؟»
برای یادگیری و پروژههای یادگیری ماشین کلاسیک، نه؛ یک لپتاپ معمولی کافی است. برای یادگیری عمیق روی دادههای بزرگ، کارت گرافیک مناسب یا سرویسهای ابری لازم میشود.
«بازار کار هوش مصنوعی در ایران چطور است؟»
تقاضا برای کسی که بتواند داده را تحلیل کند و مدل بسازد، در حال رشد است، ولی کارفرماها پروژهی واقعی میخواهند، نه مدرک. مقالهی حقوق برنامهنویس در ایران را هم ببینید.
جمعبندی
برای هوش مصنوعی به همهی پایتون نیاز ندارید؛ به پایهی محکم، سه کتابخانهی داده و بعد scikit-learn نیاز دارید. به همین ترتیب جلو بروید، برای هر مرحله پروژه بسازید و یادگیری عمیق را برای وقتی نگه دارید که یادگیری ماشین کلاسیک را واقعاً فهمیدهاید.
دورهی ماشین لرنینگ داناورس دقیقاً از همین نقطه شروع میکند: ریاضیات و آمار پایه، پیشپردازش داده، الگوریتمهای یادگیری نظارتشده و بدون نظارت، و پروژههای واقعی مثل پیشبینی قیمت و تشخیص اسپم. اگر هنوز پایتون بلد نیستید، از دورهی پایتون مقدماتی شروع کنید.